Projeto
Encontrar dispositivos suspeitos nos registos de uma firewall
Seis regras de deteção em Python que usam um dia de tráfego normal como referência e explicam que dispositivos merecem uma análise mais atenta.
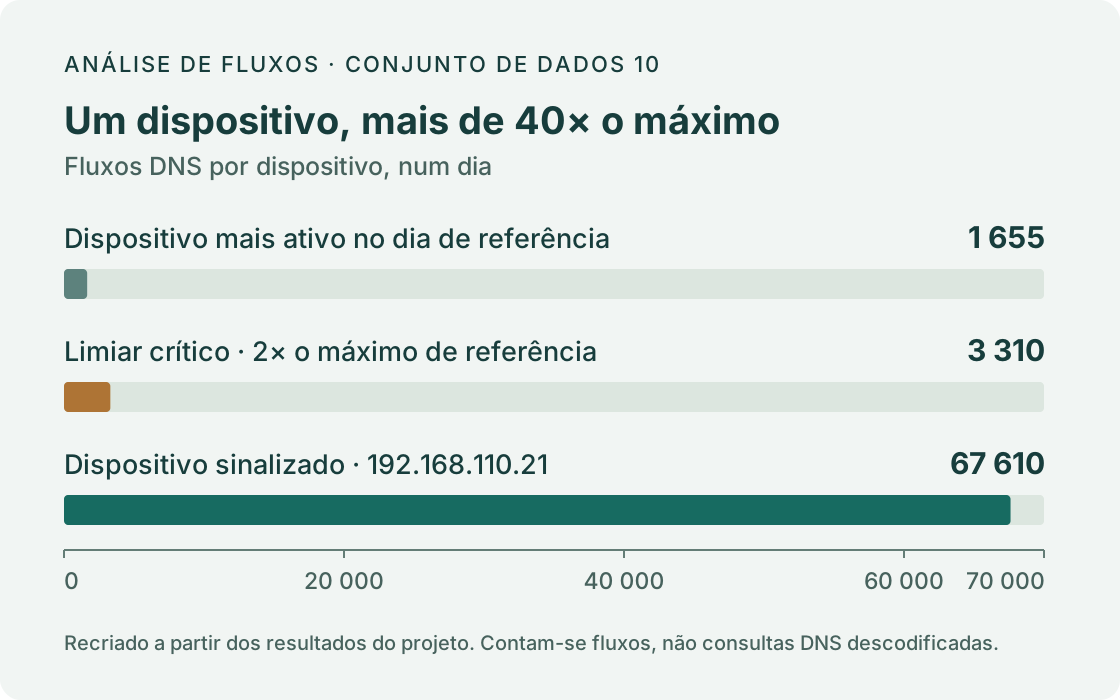
Um dispositivo nos dados de teste gerou 67 610 fluxos DNS num dia. O mais ativo no dia de referência, considerado limpo, gerou 1 655. A diferença é fácil de detetar quando se comparam as grandezas certas. O trabalho deste projeto foi chegar a essa comparação.
Implementei a análise em Python e pandas em 2025, num projeto entregue com o Gonçalo Cunha para a cadeira de Segurança em Redes de Comunicações da Universidade de Aveiro. O meu trabalho incluiu caracterizar os registos da firewall, estabelecer uma referência e escrever as seis regras de deteção. O resultado é um notebook Jupyter que identifica atividade invulgar e apresenta as medições que sustentam cada resultado.
O gráfico acima foi recriado para este artigo a partir dos resultados registados para o conjunto de dados 10. Compara contagens de fluxos, incluindo o limiar crítico da regra: o dobro do máximo observado na referência.
Começar por um dia normal
O enunciado fornecia três capturas: um dia limpo de tráfego interno, outro dia para investigar e ligações de clientes externos aos servidores públicos da empresa. Cada fluxo regista uma marca temporal, os endereços de origem e destino, o protocolo, a porta de destino e os bytes enviados e recebidos. Não há conteúdo dos pacotes nem nomes das consultas DNS.
O notebook usa por omissão o conjunto de dados 10. A referência contém 964 901 fluxos de 197 endereços de origem internos. A análise dos destinos privados e dos seus serviços identifica seis servidores internos: quatro de HTTPS e dois de DNS.
O HTTPS representa 88,1% dos fluxos de referência. Um dispositivo típico envia cerca de um byte por cada nove que recebe, e os 90% centrais dos dispositivos geram entre 6,49 e 8,44 fluxos HTTPS por cada fluxo DNS. Estas observações dão pontos de comparação úteis. Um dispositivo que envia dez bytes por cada byte que recebe merece atenção nesta rede, embora envios de grande volume possam ser normais noutro contexto.
Seis formas de perceber o que mudou
A primeira implementação usava verificações mais gerais de alterações no tráfego, nas portas, nos países e nos intervalos entre ligações. O notebook desenvolve seis regras mais específicas:
| Regra | O que compara |
|---|---|
| Comunicação interna | Volume de fluxos entre pares internos e ligações a destinos ausentes do conjunto de servidores de referência |
| Rácio de envio HTTPS | Bytes enviados divididos pelos bytes recebidos, por origem |
| Equilíbrio HTTPS/DNS | Número de fluxos HTTPS em relação aos fluxos DNS |
| Volume DNS | Contagem DNS de cada dispositivo face ao máximo da referência |
| Destinos externos | Países contactados pela primeira vez e aumentos nas contagens de fluxos por país |
| Intervalos de acesso externo | Regularidade e intervalo médio entre as ligações de um cliente |
As regras usam percentis, médias, máximos e desvios-padrão medidos, com multiplicadores de gravidade escolhidos no código. Os resultados incluem o endereço, o valor observado e o motivo pelo qual ultrapassou um limiar. Assim, é possível inspecionar a origem de um alerta.
Seguir um endereço pelas várias regras
O dispositivo com 67 610 fluxos DNS era 192.168.110.21. Enviou 34 283 fluxos para um servidor DNS interno e 33 327 para o outro. Por comparação, a referência tinha uma média de cerca de 242 fluxos por par interno de origem e destino.
O mesmo dispositivo tinha também um rácio de fluxos HTTPS/DNS de 0,110, muito abaixo do intervalo de referência. Por isso, apareceu nos resultados das regras de volume interno, equilíbrio entre protocolos e volume DNS. Dois outros endereços, terminados em .136 e .191, apresentavam a mesma sobreposição.
Estes resultados descrevem sintomas relacionados. Dão a quem investiga uma razão para examinar essas máquinas, mas as contagens de fluxos, por si só, não distinguem túneis DNS, tráfego de comando e controlo e uma carga de trabalho legítima pouco habitual.
Outro padrão envolvia quatro clientes internos a comunicar entre si nos dois sentidos, formando uma malha completa. Os seus destinos não seguiam o padrão cliente-servidor do dia limpo, pelo que a regra os sinalizou como possível movimento lateral.
Olhar para além do número de ligações
No HTTPS, a direção dos bytes foi útil. O percentil 95 do rácio entre bytes enviados e recebidos na referência era cerca de 0,112. O dispositivo 192.168.110.122 chegou a 10,820: mais de dez bytes enviados por cada byte recebido. A regra sinaliza esta mudança sem inspecionar o conteúdo cifrado.
Os intervalos entre ligações deram outra perspetiva sobre os clientes externos. Para cada origem com pelo menos dez fluxos, o notebook ordena as marcas temporais, mede os intervalos e calcula o seu coeficiente de variação:
CV = desvio-padrão dos intervalos entre ligações / intervalo médio × 100Três clientes que contactavam o mesmo servidor público tinham intervalos médios de cerca de 8,5–8,6 segundos e valores de CV próximos de 23,6%. O percentil 5 do CV da população era cerca de 369%. A regularidade muito maior destes clientes tornava-os candidatos a uma análise mais atenta. Esta regra compara clientes dentro da própria captura de acesso aos servidores; não tem uma referência externa limpa e separada.
Interpretar os resultados no seu contexto
O relatório final selecionou 19 endereços internos e três externos para a avaliação conjunta. Esse é o resultado da investigação apresentada no relatório, não uma medida da precisão da deteção. As regras individuais do notebook podem devolver conjuntos de endereços mais amplos e sobrepostos.
Um único dia de referência também limita o que se pode considerar «invulgar». Os endereços dos dispositivos precisam de se manter estáveis, os períodos de observação têm de ser comparáveis e as cargas de trabalho normais podem variar de dia para dia. Seriam necessários mais dias de referência e dados de avaliação etiquetados para medir falsos positivos e deteções em falta.
O repositório contém tudo o que é necessário para acompanhar a investigação offline: o notebook, os conjuntos de dados locais e as bases GeoLite2, o módulo de regras anterior e os dois relatórios do projeto.